“Tôi không nhìn cô ấy đâu”
Hãy tưởng tượng một anh robot đang lấy một tay che mắt. Tay còn lại, anh ta chỉ thẳng về phía cô robot đứng sau lưng rồi quả quyết:
I don’t see her.
Nghe có vẻ rất nghiêm túc. Nhưng nếu thật sự không để ý, tại sao anh ta biết chính xác cô ấy đang đứng ở đâu?
Đó cũng là cái khó khi chúng ta nói với AI:
Đừng viết sáo rỗng. Đừng quảng cáo quá. Đừng nhắc đến đối thủ. Đừng nghĩ đến cô ấy.
Càng liệt kê những điều không muốn thấy, ta càng đưa chúng vào ngay giữa câu lệnh. AI chưa chắc làm trái lời, nhưng nó buộc phải xử lý đúng những khái niệm vừa bị cấm.
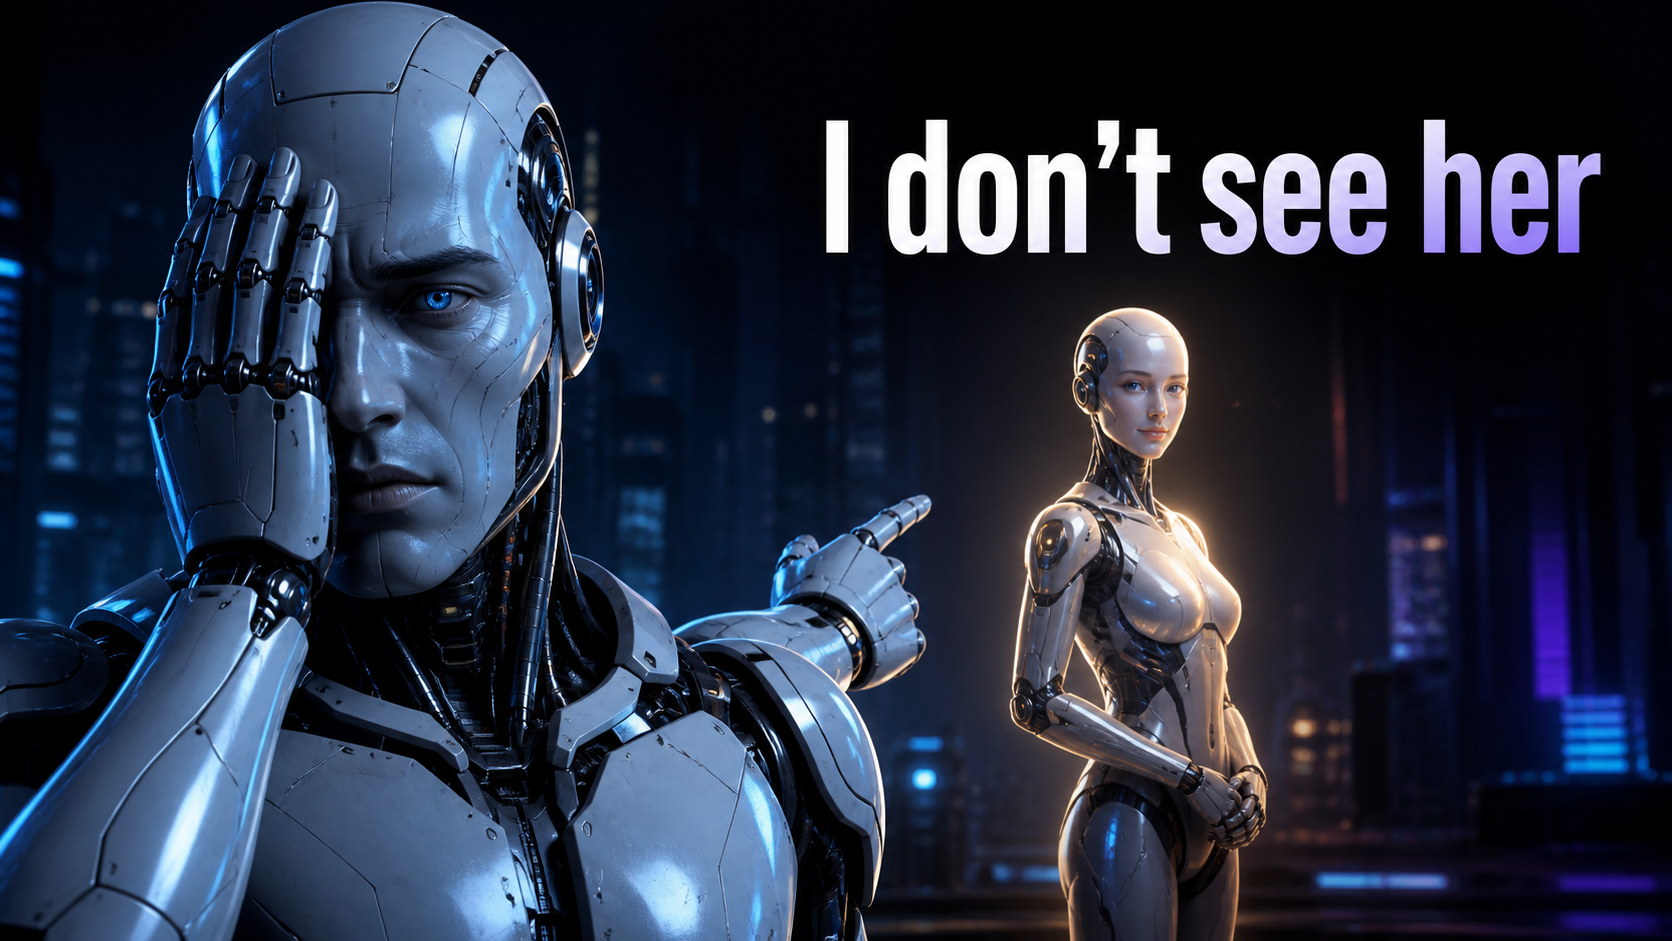 Miệng nói không nhìn, nhưng cả câu lệnh lại hướng sự chú ý về đúng một người.
AI có thật sự tò mò không?
Nếu hiểu tò mò là cảm giác muốn biết, muốn khám phá như con người thì không. Mô hình ngôn ngữ không yêu, không ghen và cũng không có một cô gái nào nằm trong tiềm thức.
Nhưng AI được học từ ngôn ngữ do con người tạo ra. Trong khối dữ liệu đó có những liên tưởng, thói quen diễn đạt và cách con người nối ý này với ý khác. Khi ta nhắc một khái niệm trong câu lệnh, khái niệm ấy trở thành một phần của bối cảnh mà mô hình dùng để viết câu tiếp theo.
Nếu muốn gọi hiện tượng này là “trí tò mò của AI”, ta nên hiểu đó là sự tò mò mang tính thống kê. AI không thật sự muốn nhìn cô robot. Chỉ là xác suất sinh câu tiếp theo đã bị kéo về phía cô ấy.
Chuyện con gấu trắng
Năm 1987, Daniel Wegner và các cộng sự thực hiện một thí nghiệm nổi tiếng: yêu cầu người tham gia đừng nghĩ đến một con gấu trắng. Muốn kiểm tra mình có làm đúng hay không, họ lại phải gọi hình ảnh con gấu vào đầu. Nghiên cứu ghi nhận việc cố dồn nén suy nghĩ có thể khiến nó quay lại mạnh hơn ở giai đoạn sau. Paradoxical Effects of Thought Suppression
AI không có bộ não giống người, nên không thể lấy thí nghiệm này làm bằng chứng rằng AI có vô thức. Tuy vậy, phép so sánh vẫn rất hữu ích: một điều cấm phải được gọi tên trước khi nó được loại bỏ.
Với mô hình ngôn ngữ, chữ “không” không phải nút xoá. Nó chỉ là một phần của câu. Mô hình phải hiểu chữ “không” đang phủ định điều gì, phạm vi đến đâu, rồi giữ ràng buộc đó trong lúc tiếp tục tạo nội dung.
Các nghiên cứu về câu lệnh phủ định cho thấy đây là điểm yếu có thật. Một nghiên cứu đã đổi chín tác vụ quen thuộc thành phiên bản có phủ định và nhận thấy mô hình lớn hơn không tự nhiên làm tốt hơn; trong một số trường hợp, kết quả còn tệ đi. Can Large Language Models Truly Understand Prompts?
Một bộ kiểm tra khác với khoảng 400.000 câu mô tả kiến thức thông thường cũng cho thấy mô hình xử lý câu phủ định kém ổn định hơn câu khẳng định. This is not a Dataset
Điều này không có nghĩa AI không hiểu chữ “không”. Nó chỉ nhắc ta rằng câu lệnh phủ định không phải lúc nào cũng là cách điều khiển tốt nhất.
Đừng chỉ tả cái hố, hãy tả con đường
Giả sử bạn muốn AI viết một báo cáo rõ ràng. Cách quen thuộc là:
Đừng dài dòng. Đừng nói chung chung. Đừng dùng lời quảng cáo.
Yêu cầu này nói rất rõ điều ta ghét, nhưng không nói kết quả tốt trông như thế nào. Một cách giao việc dễ làm hơn là:
Viết cho một người quản lý đang bận. Mỗi đoạn nêu một ý chính, một ví dụ hoặc số liệu minh hoạ, rồi nói rõ việc đó ảnh hưởng gì đến quyết định của họ. Toàn bài không quá 800 từ.
Bây giờ AI đã biết người đọc là ai, cấu trúc mỗi đoạn ra sao và điểm dừng nằm ở đâu.
Hướng dẫn viết câu lệnh của Anthropic cũng đi theo hướng này: nói thẳng điều cần làm, nêu rõ bối cảnh và dùng ngay giọng điệu mong muốn trong câu lệnh. Prompting best practices
Mỗi điều cấm đều tạo thêm một việc phải nhớ
Một danh sách cấm dài làm AI phải gánh ba việc cùng lúc:
- nhớ những điều bị cấm;
- hiểu từng điều cấm áp dụng cho phần nào;
- tự nghĩ ra cách làm thay thế.
Câu lệnh càng dài, các yêu cầu càng dễ cạnh tranh với nhau. AI vừa lo nội dung, giọng văn, độ dài và định dạng, vừa phải canh hàng chục biển cấm.
Nghiên cứu DeCRIM cho thấy ngay cả GPT-4 cũng bỏ sót ít nhất một điều kiện trong hơn 21% yêu cầu nhiều ràng buộc của bộ dữ liệu RealInstruct. Cách làm tốt hơn trong nghiên cứu này là tách các điều kiện, kiểm tra từng phần rồi sửa đúng lỗi. LLM Self-Correction with DeCRIM
Vì vậy, nếu buộc phải dùng câu cấm, hãy luôn chỉ ra hành động thay thế.
| Thay vì chỉ nói | Hãy giao việc như sau |
|---|---|
| “Đừng suy đoán.” | “Chỉ kết luận từ thông tin đã cho. Nếu chưa đủ dữ liệu, hãy nói rõ còn thiếu gì.” |
| “Đừng dài dòng.” | “Viết ba đoạn, mỗi đoạn không quá ba câu. Câu đầu nêu ý chính.” |
| “Đừng nói như AI.” | “Viết như một người làm nghề đang giải thích thẳng thắn cho đồng nghiệp.” |
| “Đừng nhắc đối thủ.” | “Chỉ so sánh sản phẩm với nhu cầu khách hàng và số liệu đã được xác minh.” |
Có những việc không được giao cho lời dặn
Đến đây rất dễ kết luận rằng chỉ cần viết câu lệnh hay là đủ. Không phải.
Nếu AI được phép gửi tiền, xoá tệp, đọc dữ liệu riêng tư hoặc gọi một hệ thống đang chạy thật, câu “đừng làm sai” gần như vô nghĩa. Ta không cần một lời dặn nghiêm hơn. Ta cần phần mềm chặn thao tác sai.
Ví dụ:
- Muốn AI trả về JSON đúng cấu trúc: dùng JSON Schema để kiểm tra.
- Không muốn AI xoá tệp: không cấp quyền xoá tệp.
- Chỉ được gọi ba công cụ: chỉ cung cấp đúng ba công cụ đó.
- Không muốn lộ dữ liệu nhạy cảm: lọc dữ liệu trước khi đưa vào mô hình.
AI có thể đề xuất. Phần mềm mới là bên quyết định thao tác nào được chạy.
Việc mềm dùng ngôn ngữ, việc cứng dùng kiến trúc
Không phải ràng buộc nào cũng cần mức kiểm soát giống nhau.
Ngôn ngữ phù hợp để hướng dẫn giọng văn, mục tiêu và cách trình bày. Kiến trúc phù hợp để kiểm soát quyền truy cập, cấu trúc dữ liệu và những thao tác có hậu quả lớn.
Nguyên tắc rất đơn giản: nếu một việc tuyệt đối không được phép xảy ra, đừng chỉ yêu cầu AI nhớ là không được làm. Hãy thiết kế hệ thống để nó không thể làm.
Trước khi thêm một câu “đừng”
Lần tới khi sửa câu lệnh, hãy tự hỏi:
- Nếu không nhắc đến lỗi, kết quả tốt sẽ trông như thế nào?
- Tôi đã nói rõ người đọc, mục tiêu và cách trình bày chưa?
- Có thể đưa một ví dụ ngắn về kết quả mong muốn không?
- Điều cấm này đã có một cách xử lý thay thế chưa?
- Nếu đây là giới hạn tuyệt đối, tại sao tôi chưa chặn nó bằng phần mềm?
Kết
Hình ảnh anh robot che mắt nhưng vẫn chỉ đúng về phía cô robot là một phép ẩn dụ vui. AI không yêu cô ấy. Nó cũng không tò mò theo cách chúng ta tò mò.
Nhưng mô hình được xây từ ngôn ngữ của con người, và ngôn ngữ luôn để lại dấu vết. Khi ta nói “đừng nghĩ đến cô ấy”, ta đã đưa cô ấy vào giữa câu lệnh.
Muốn AI cho kết quả tốt, hãy mô tả rõ nơi nó cần đến. Muốn ngăn một hành động nguy hiểm, hãy dựng giới hạn bằng phần mềm. Còn nếu chỉ đứng ở đầu đường và liên tục hô “đừng đi vào rừng”, đừng quá ngạc nhiên khi cả cuộc trò chuyện chỉ còn xoay quanh khu rừng đó.